Le paquetage buildez.pdb inclue un module fluct.py destiné à quelques mesures élémentaires de fluctuations atomiques dans les structures PDB. Les fonctions correspondantes s’appliquent à des structures parfaitement identiques en séquence et dans les atomes pour chaque chaque résidu. Le module utilise une matrice pdbm qui permet de limiter très rapidement le codage et le captage des coordonnées moléculaires, in fine deux structures sont comparées et une matrice de fluctuation est produite à partir de la différence entre deux matrices de distances. Les deux structures de données peuvent servir de base pour différents processus, calculs ou visualisations.
Nous utiliserons deux structures de InhA, une enzyme qui correspond à une Enoyl-[acyl-carrier-protein] reductase et qui utilise un cofacteur : le NADH. Cette enzyme se caractérise aussi par une certaine dynamique structurale. Par exemple, une entrée catalytique est présente d’un coté du site (portail majeur), mais une autre ouverture (portail mineur) peut faire son apparition, à l’opposé de la première, dans certaines entrées de la PDB. Le fichier frame21.pdb correspond à la chaine A de la structure 3FNG [Freundlich_2009]. Cette structure est utilisée en tant que référence, le portail mineur est encore fermé. Le fichier frame42.pdb correspond à la chaine A de la structure 2X22 [Luckner_2010]. Cette structure est utilisé pour la comparaison (query), avec une différence structurale: cette fois le portail mineur est ouvert.
Publication initiale sur buidez.net (2014) – Article mis à jour en Mai 2025.
Navigation dans le guide
Guide [ Composants : buildez.pdb ]
1. Matrice de distances
La matrice de distance se calcule très simplement à partir d’une matrice pdbm, à partir de la fonction pdb_pdbm2distmat, une partie de cette fonction est chargée de calculer la matrice, le code est trivial :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
def pdb_pdbm2distmat(pdbm, chain='', atom_type=''): """ Same as pdb_str2distmat but using a pdbm matrix as input and for any kind of atom depending on the value of argument atom_type. *** warn: the pdbm matrix given in argument will be destroyed """ ... # make the distance matrix for i in range (0, len(pdbm), 1): row = [] for j in range (0, len(pdbm), 1): d = pdb_atom_dist(pdbm[i], pdbm[j]) row.append(d) distm.append(row) # cleanup matrix_del(pdbm) # done return (distm, resname, resseq) |
La fonction pdb_atom_dist fait partie du module pdb.distance et prend directement deux lignes de matrices pdbm (une pour chaque atome) et calcule la distance Euclidienne en 3 dimensions. Cette fonction peut également sélectionner la chaine à laquelle on s’intéresse via l’identifiant de chaine, ainsi que les types d’atomes. Elle renvoie une matrice de distance distm, ainsi que la liste des résidus (noms RESNAME et numéros RESSEQ) ce qui est utile si on a fait une sélection par chaine polypeptidique.
Dans le code précédent nous voyons que la matrice de distance correspond à la distance entre chaque atome de la matrice pdbm, il s’agit donc d’une matrice symétrique avec une diagonale à zéro.
La fonction pdb_pdbm2distmat utilise une pdbm pour faire le calcul, sans sélection particulière de la chaîne ou du type d’atomes (CA, C, N, O, etc). Si ces arguments sont renseignés, la fonction réduit en conséquence la matrice pdbm. Le choix du type d’atome est strict, il suffit d’entrer la chaîne de caractères correspondante (par exemple ‘CA’ pour CA, carbone alpha).
L’utilisation de cette fonction est simple comme le montre le code:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
print("*** distances calculation") s = pdb_file2str(r_fname) print("generate a pdbm matrix reduced to the 100 first atoms") pdbm = pdb_str2pdbm(s)[0:100] print("selected %d atoms" % (len(pdbm))) print("compute distance matrix") (distm, resname, resseq) = pdb_pdbm2distmat(pdbm, chain='A', atom_type='CA') print("print distance matrix") for i in range (0, len(distm), 1): print(distm[i]) print("residue names in this distance matrix") print(resname) print("residue numbers in this distance matrix") print(resseq) |
La variable r_fname correspond à un de fichier PDB, par exemple r_fname = 'test/frame21.pdb'.
Le code précédent donnera alors le résultat suivant :
*** distances calculationgenerate a pdbm matrix reduced to the 100 first atomsselected 100 atomscompute distance matrixprint distance matrix[0.0, 3.784, 6.188, 8.610, 7.50, 11.028][3.784, 0.0, 3.794, 5.207, 4.705, 8.448][6.188, 3.7949, 0.0, 3.800, 5.774, 9.266][8.610, 5.207, 3.800, 0.0, 3.810, 6.343][7.507, 4.705, 5.774, 3.810, 0.0, 3.795][11.0286, 8.448, 9.266, 6.343, 3.795, 0.0]residue names in this distance matrix['THR', 'GLY', 'LEU', 'LEU', 'ASP', 'GLY']residue numbers in this distance matrix[2, 3, 4, 5, 6, 7] |
Pour faciliter la lisibilité, la matrice pdbm a été volontairement réduite aux 100 premiers atomes de la structure et la matrice de distances à 3 chiffres après la virgule à partir de la colonne d’indice 2.
Il existe des cas ou il est plus pratique de procéder avec une chaîne de caractères qui contient le fichier PDB qu’avec une matrice pdbm. C’est en particulier le cas lorsque on a un fichier multi-modèle contenant plusieurs conformations (par exemple structures obtenues par RMN). La fonction pdb_str2distmat s’utilise alors, elle nécessite comme argument supplémentaire le numéro de modèle sous forme d’indice (0 .. n-1) et non d’index (1 .. n).
Un comptage préalable du nombre de modèles (via la fonction pdb_str_model_count du module pdb.str) est effectué et si la structure ne comporte qu’un modèle (ou si on à affaire à une structure standard) l’équivalent du premier modèle est utilisé. Une fois le modèle extrait, il est transformé en matrice pdbm et la fonction pdb_pdbm2distmat prendra le relais.
Composition de la matrice de distances
En suivant l’exemple précédent, pour les 100 premiers atomes de la pdbm, nous avions 6 carbones alpha (atomes de 1 à 6). La distance est mesurée pour chaque paire d’atomes impliqués. Ce qui nous donne ce type de matrice, positive et symétrique.
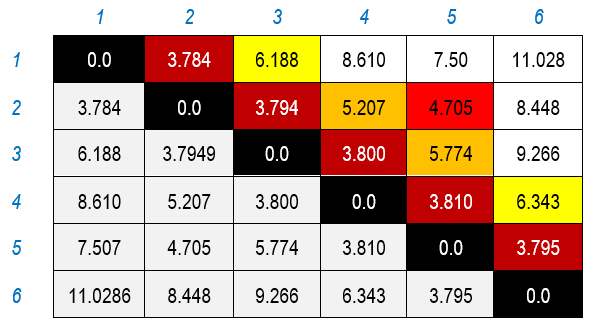 |
Nous remarquerons une seconde diagonale avec des distances autour de 3.8 Å, il s’agit des distances entre CA voisins (qui sont liés via les liaisons peptidiques). En combinant ces valeurs avec les autres valeurs de la matrice nous pourrions peut être reconstruire la séquence.
Par exemple l’atome 5 est voisin de 4 et de 6, nous avons 4-5-6. L’atome 5 est proche mais pas voisin de 2 et 3, et 3 est voisin de 4, nous avons 3-4-5-6 … sauf que la distance 5-2 est très faible, 4.705 Å alors qu’elle devrait être supérieure à 5 Å pour les CA externes de 3 résidus globalement alignés.
Tout se passe comme s’il y avait un coude dans la chaine protéique. Si nous regardons les 6 premiers CA dans la structure (on affiche la lysine suivante pour avoir la visualisation du backbone), nous avons :
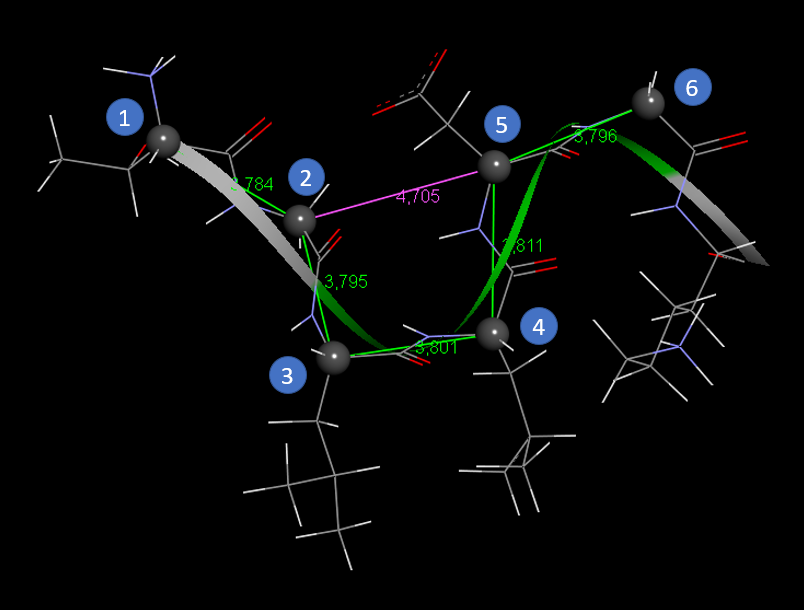 |
Il y a bien un coude du backbone qui semble indiquer le début d’une hélice alpha (mais ce n’est pas le cas). Les distances ne correspondent pas tout à fait à la troisième décimale, car dans l’affichage des résultats du code j’ai tronqué manuellement les valeurs pour qu’elles soient plus lisibles, alors que Discovery Studio les a arrondies.
2. Matrice de fluctuations
Son calcul se fait simplement par calcul de la différence (atome par atome) entre les distances enregistrées dans deux matrices de distances. Les deux matrices doivent correspondre à la même structure, ce type d’outil est essentiellement dédié à la mesure de fluctuations d’une même macromolécule.
La fonction pdb_distmats2flucmat_diff est utilisée pour cette opération, il est certainement possible d’implémenter d’autres mesures de fluctuations à partir des matrices de distances.
Dans le cas général, des interfaces à cette fonction sont plutôt utilisées, car il est plus pratique de travailler directement à partir de deux fichiers PDB ou de leurs représentations sous formes de chaînes de caractères. C’est le cas de la fonction pdb_strs2flucmat_diff qui travaille en mode chaîne et de son interface pdb_files2flucmat_diff qui utilise deux noms de fichiers. Ces fonctions comportent un sélecteur de lettre (A, B …) pour la chaîne polypeptidique, un sélecteur de modèle (0 .. n-1) pour les fichiers PDB multi-modèles, un sélecteur d’atome (‘CA’ cabones alpha, par défaut) pour la comparaison.
Si on veut utiliser des types d’atomes multiples il vaut mieux revenir au calcul par pdb_distmats2flucmat_diff à partir des matrices de distances, qui offre plus de flexibilité.
Un exemple d’utilisation avec le code suivant:
|
1 2 3 4 5 6 7 8 9 10 |
print("*** fluctuations calculation") print("-> using pdb_files2flucmat_diff subroutine (debug=True)") print("compute fluctuation matrix (default: chain=A, atom_type='CA')") fm = pdb_files2flucmat_diff(r_fname, f_fname, rn=0, fn=0, debug=True) print("output of 5 first rows/columns and of fluctuation matrix") for i in range (0, 5, 1): print(fm[i][0:5]) print("=> compute min and max fluctuations") (fmin, fmax) = pdb_flucmat_minmax(fm) print("min=%f max=%f" % (fmin, fmax)) |
Qui va donner le résultat:
*** fluctuations calculation-> using pdb_files2flucmat_diff subroutine (debug=True)compute fluctuation matrix (default: chain=A, atom_type='CA')reference structure [0:2][0:2][0,0] 0.000000[1,0] 3.784144[0,1] 3.784144[1,1] 0.000000query structure [0:2][0:2][0,0] 0.000000[1,0] 3.852032[0,1] 3.852032[1,1] 0.000000chain={A} atom_type=[CA] -> fluct[0:2][0:2][0,0] 0.000000[1,0] -0.067888[0,1] -0.067888[1,1] 0.000000output of 5 first rows/columns and of fluctuation matrix[0.0, -0.067, -0.578, -0.159, 0.292][-0.067, 0.0, -0.037, -0.276, -0.307][-0.578, -0.037, 0.0, -0.014, -0.087][-0.159, -0.276, -0.014, 0.0, 0.001][0.292, -0.307, -0.087, 0.001, 0.0]=> compute min and max fluctuationsmin=-6.966186 max=5.796482 |
Le même traitement a été appliqué à la matrice de fluctuation que dans l’exemple précédent de manière à faciliter la lisibilité des résultats. Le mode debug=True de la fonction pdb_files2flucmat_diff est utilisé, qui affiche les deux premiers éléments de chaque matrice utilisée dans un calcul intermédiaire. La dernière fonction pdb_flucmat_minmax calcule les valeurs min en max de la matrice ce qui peut être utile pour des représentations graphiques des fluctuations.
Composition de la matrice de fluctuation
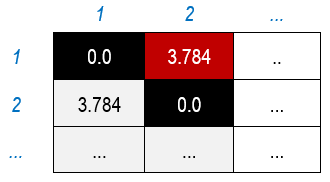
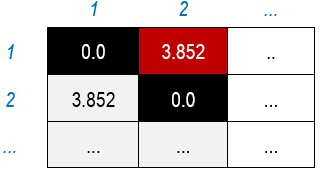
La matrice de fluctuation correspond à la différence de deux matrices de distances, de même dimensions, concernant la même protéine, les mêmes résidus et les mêmes atomes pour les résidus. Si nous reprenons l’exemple, nous allons utiliser frame21.pdb (utilisé comme référence, exemple précédent) et frame42.pdb (utilisé comme interrogation). Pour les 100 premiers atomes des deux pdbm correspondantes, nous avons le début (deux premiers atomes) de deux matrices de distances, réduites aux carbones alpha :
 |
 |
| frame21 {reference} | frame42 {query} |
C’est ce qui correspond aux affichages reference structure [0:2][0:2] et query structure [0:2][0:2] dans la sortie précédente. Nous faisons la différence de ces deux matrices pour obtenir la matrice de fluctuation :
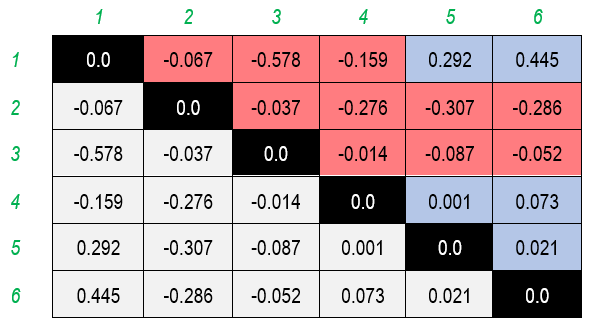 |
Cette matrice est également symétrique, avec la diagonale à zéro. Nous avons perdu la seconde diagonale correspondant aux carbones alpha car il s’agit de différences dans les distances interatomiques de deux protéines, par contre, nous avons maintenant des éléments positifs et négatifs dans la matrice.
3. Référentiel
Fonctions du module fluct.py en mode abrégé (mai 2025).
| Fonction | Utilisation |
pdb_str2distmat |
Interface texte pour pdb_pdbm2distmat, le fichier PDB est introduit sous la forme d’une chaine de caractères (string). Filtrage possible sur le numéro de modèle, les identifiants de chaine et de type d’atomes. |
pdb_pdbm2distmat |
Lecture d’une matrice pdbm avec un filtrage possible sur l’identifiant de chaine et le type d’atome. Renvoie trois listes: une matrice de distances atomiques, une liste d’identifiants et une liste de numéros pour les résidus impliqués. |
pdb_distmats2flucmat_diff |
Lit deux matrices de distance (reference, query) et renvoie une matrice de fluctuations. |
pdb_strs2flucmat_diff |
Interface texte pour pdb_distmats2flucmat_diff, entrée de deux chaines de caractères pour chaque structure, de deux numéros de modèles (zéro par défaut), des identifiants de chaine et de type d’atome. Mode debug=False par défaut. Renvoie une matrice de fluctuation. |
pdb_files2flucmat_diff |
Interface à pdb_strs2flucmat_diff qui utilise le nom des fichiers PDB plutôt que les chaines de caractères issues de la lecture de ces fichiers. |
pdb_flucmat_minmax |
Retourne un couple de flottants correspondant aux valeurs minimales et maximales de la matrice de fluctuation entrée comme argument. |
4. Conclusion
Ce module et ces matrices servent de base pour d’autres calculs ou des outils de visualisation, par exemple Matplotlib/PyLab, Seaborn … après transformation en Array (au sens de Numpy ou de Scipy) ou en DataFrame (au sens de Pandas) . Le paquetage buildez fournit des outils de transformation, par exemple la fonction matrix_float_m2array du module buildez.matrix.
Les mesures de fluctuations ont différentes applications, elles sont notamment mises en œuvre pour des processus d’analyse après un calcul de modes normaux de vibration des protéines (par exemple ElNémo [Suhre_2004 – https://doi.org/10.1093/nar/gkh368]). L’article [ buildez.pdb : utiliser un fluctuomètre simplifié ] montrera un exemple d’utilisation étendu à toute une protéine et issu de ces idées.
Une question qui est posée est celle de l’utilisation de RMSD (Root Mean Square Deviation of atomic positions) plutôt que de distances, la réponse est simple on utilise les RMSD pour des groupes d’atomes, et il existe dans buildez.pdb un module localrmsd qui est dédié à ce type de mesures. Pour des mesures intermoléculaires, j’ai mis en place une structure de données spécialisée, la proxmap (module pdb.proxmap.py) qui est plus pratique à utiliser dans ce contexte.
Liens et lectures
- Domaine UniProt P9WGR1 · INHA_MYCTU [ https://www.uniprot.org/uniprotkb/P9WGR1/entry ].
- Structure 3FNG [ https://www.rcsb.org/structure/3FNG ].
- Structure 2X22 [ https://www.rcsb.org/structure/2X22 ].
- SciPy.org [ https://scipy.org/ ] et NumPy [ https://numpy.org/ ].
- Matplotlib: Visualization with Python [ https://matplotlib.org/ ].
- Utilisation de PyLab [ https://courspython.com/pylab.html ].
- Matplotlib – PyLab module [ https://www.tutorialspoint.com/matplotlib/matplotlib_pylab_module.htm ].
- ElNémo: The Elastic Network Model [ https://www.sciences.univ-nantes.fr/elnemo/ ].